
职场里有个挺普遍的尴尬:PPT早就做完了,汇报视频却迟迟交不出去。
原因不复杂。多数人卡的不是内容,是录制。对着屏幕讲一遍,回放一听,语速快了、停顿怪了、某页解释少了,于是重来。反复几次,耐心耗尽,最后要么硬着头皮交一版自己都不满意的,要么拖到截止时间前才匆忙导出。
问题出在哪?出在“讲”和“录”被绑在了一起。只要这个绑定不解除,改稿就等于重录,重录就等于加班。
换一个思路,把这两件事拆开,情况会完全不同。
一、传统做法卡在哪个环节
自己录屏配音。最大的成本不是录制本身,是“录到一半发现前面有问题”。五分钟的成品,背后可能是四十分钟的反复。而且人对自己的声音往往挑剔,越听越不满意,陷入修改循环。
PPT加背景音乐直接导出。省事,但信息传递效果差。接收方看不到重点在哪,一页页翻过去,注意力很快就散了。
只发文字稿。阅读成本高,容易被搁置。汇报场景下,视频的完成度感知明显强于文档。
这三种方式的共同问题是:内容修改和成品制作之间没有缓冲。改一个字,就要动整个成品。
二、把“讲”和“录”拆开
核心思路很朴素:先定稿,再配音;配音不改稿,改稿不重录。
讲稿以文字形式确认,配音由工具根据文字生成。文字变了,重新生成一次语音即可,前面的画面、结构、时间轴都不受影响。
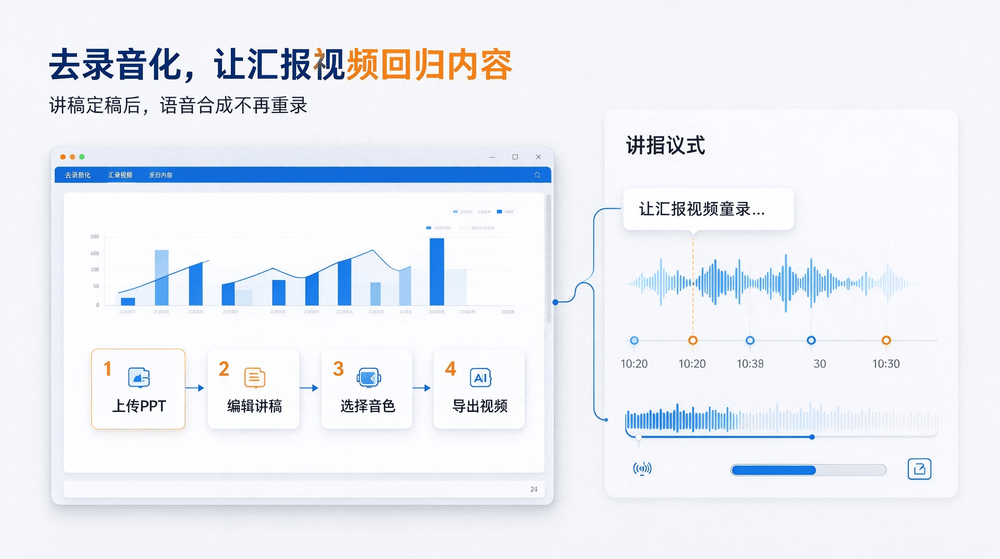
PPTTalk就是按这个逻辑设计的。上传PPT之后,系统自动生成每一页的讲稿草稿,人工修改定稿,然后选择声音合成,最后导出视频。整个过程里,讲稿是唯一的变量,其他环节都是自动的。
三、四步流程
第一步,上传PPT。不用转换格式,不用拆页导出图片,文件直接上传,系统识别页面内容,作为生成讲稿的依据。
第二步,处理讲稿。系统会按页给出初稿,但初稿是起点,不是终点。它省去了从空白文档开始组织语言的麻烦,语气、重点、详略仍需自己调整。PPTTalk的单页讲稿支持直接编辑,也可以用AI润色。改动只发生在文字层面,不涉及录制。
第三步,确定声音。两种路径:一是从音色库中选,多种音色按汇报场合挑一个合适的即可,合成效果自然;二是定制专属声音,录制十秒以上样本上传,系统生成个人声音模型,之后可复用到所有PPT上。稿子改了,声音模型不变,重新生成就行。
第四步,导出视频。讲稿和声音确认后,一键合成,系统自动将语音与每一页画面对齐,输出mp4文件,不需要手动卡时间点。从上传到导出,熟练之后三分钟左右可以完成。
四、实际优势
改稿成本极低。数据更新、措辞调整、顺序微调,都只改文字,不碰录音,版本迭代不再意味着推倒重来。
不用露脸,不用练稿。省掉了镜头前的紧张感和反复试录的时间。
输出稳定。人工录制受状态影响,工具合成不受情绪和精力波动影响,每次输出质量一致。
时间可控。传统方式里录制时间不可预测,这套流程把制作时间压缩到可预期范围内。
五、适用场景与边界
推荐使用:周期性的工作汇报,如周报、月报、季度总结;项目结项、复盘类的讲解视频;远程协作中需要异步传达信息的场景;内容需要多次修改、快速出片的场合。
不建议使用:汇报本身要求真人出镜、有肢体语言表达的;对视频有特殊剪辑需求的。
六、一点补充
汇报视频的本质是信息传递,不是才艺展示。把精力花在内容打磨上,比花在反复录制上更有价值。
PPTTalk解决的就是制作环节的效率问题:上传PPT、生成讲稿、选择或定制声音、合成导出,四步走完。中间那些耗时的、重复的、容易出错的环节,交给工具处理。
如果正被汇报视频困住,不妨拿一份现成的PPT试一遍。流程顺不顺,用一次就有判断。